OpenAI新模型跑分全球第二,网友却骂“还不如豆包”,开发者弃用Codex



摘要:
本来花钱请AI帮自己省事,最后还得花一个上午给AI收拾残局。
凤凰网科技 出品
作者|施言
编辑|董雨晴
11月17日,OpenAI正式发布了GPT-6.2 Astra和Sol。
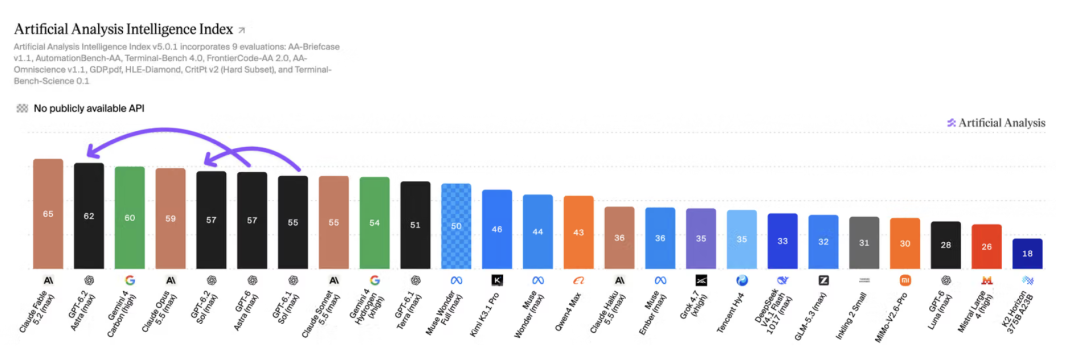
第三方评测机构Artificial Analysis给Astra打出了62分的综合智能指数,发布时排名全球第二。Astra的API价格也比上一代降低了20%。
结果模型刚上线,国内开发者社区迎来了铺天盖地的差评。
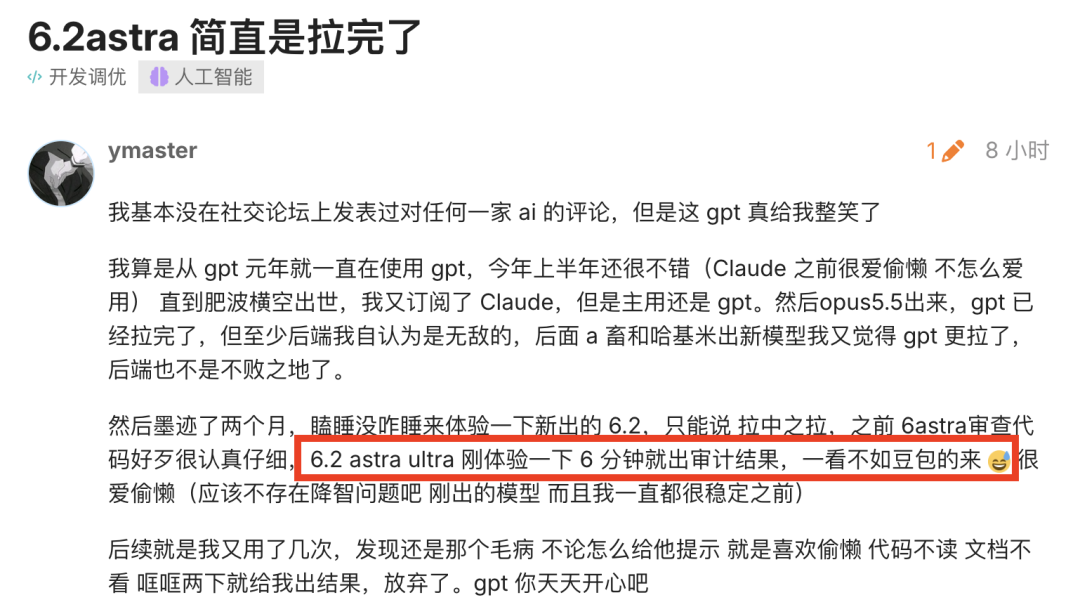
LINUX DO平台一位老用户称等了两个多月,第一时间拿新版Astra审查代码,结果只用了6分钟就交卷。他看完觉得相当敷衍,直接发帖吐槽:“一看不如豆包”,最后又给了个评价:“拉中之拉”。
每月100美元,Codex老用户还是退订了
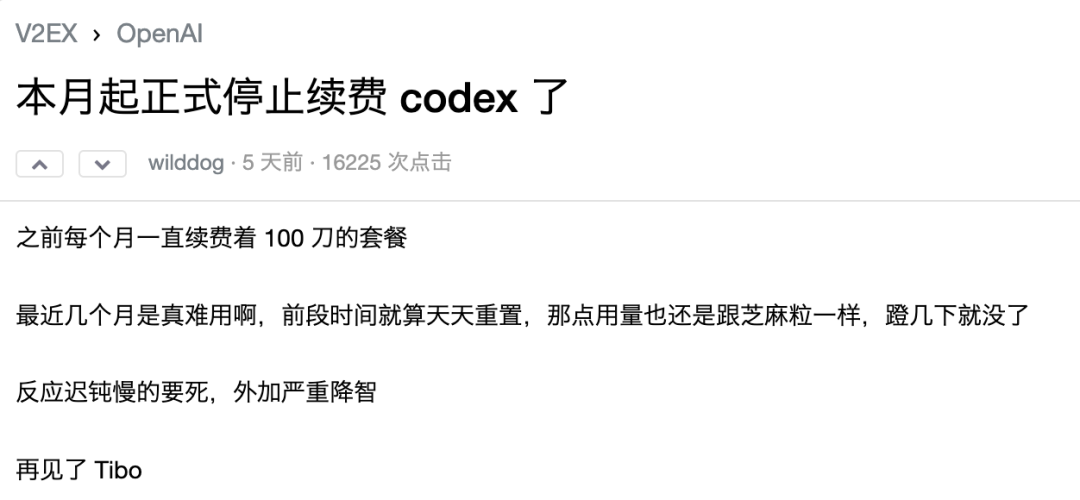
就在新模型发布前几天,V2EX已经有Codex老用户宣布停止续费了。
这位用户此前每个月花100美元购买套餐,最近几个月却越来越受不了模型的表现:反应迟钝、执行速度慢,额度也不够耐用。
最后干脆决定不续费了,留下一句:“再见了 Tibo。”
这条帖子评论区有两位开发者分享经历,倒是挺能解释大家为什么会被Codex折腾得没脾气。
一位网友说,自己刚花了一整个上午,把Codex前一天在核心模块里修改出的约200行代码,精简到了不到10行。
AI前一天忙活了一通,程序员第二天还得重新检查、删改,把大量多余实现清理掉。尤其是核心模块,谁也不敢不看代码就直接合并,万一影响其他功能,后面还有更多麻烦。
以前程序员用AI写代码,可能担心它写得不够多。现在有时候反过来了,Codex太喜欢把简单问题复杂化,十行就能完成的功能,偏偏折腾出几百行。
另一位网友的经历更让人崩溃。
他让Astra Ultra在一个几百行的YAML配置文件里,增加一个只有几行内容的配置块。结果模型折腾了一个半小时,还没有完成。
按照他的描述,Astra每次只读取目标位置附近十行内容,然后写脚本修改文件。改完不是缩进有问题,就是转义符不正确,遇到语法错误后又重新读取附近十行,继续分析、修改、报错。
用户中途打断过模型,也尝试纠正做法、压缩上下文、重新开启会话,结果还是反复陷入同样的循环。
更离谱的是,模型有时光是思考怎么写一个简单的Python修改脚本,就能花掉五分钟。后面再次遇到语法错误,又重新分析五分钟,时间就这么一点点消耗掉了。
一个是把简单代码写得过于复杂,另一个是修改几行配置却陷入错误循环。两件事都不算什么特别复杂的开发任务,用户却为此付出了不少时间。
本来花钱请AI帮自己省事,最后还得花一个上午给AI收拾残局。
GPT-6.2刚上线,怎么又得重新调教?
GPT-6.2上线以后,有开发者发现,6.2 Sol似乎变得更容易提前停工了。
一位用户本来正在让模型执行一个长任务,中途想了解工作进度,于是要求它先给一份阶段性报告。模型把报告写出来以后,居然直接结束了任务,后面的工作也不继续执行。
这位用户表示,前一天使用6.1 Sol时,并没有出现类似情况。
这就好比,你安排同事做一个项目,中途问一句进度怎么样,对方认真汇报完,然后就收拾东西下班了。你甚至得专门提醒他,刚才只是汇报进度,后面的事情还得继续做。
这就不得不惊叹一句,这也太莫名其妙了!
而且模型升级以后,原来用得好好的工作流程,还可能需要重新适配。
不少重度用户会专门编写AGENTS.md,设置项目规则和工具权限,甚至研究怎么让多个Agent协作。前面花了不少精力才调顺手的工具,GPT升级后,又得重新摸索它的习惯。
国外还有用户遇到了更夸张的异常。
11月18日,Reddit一位开发者晒出了Codex日志。他原本使用GPT-6.1 Sol Max正常工作,切换到6.2 Sol Max以后,客户端突然开始反复压缩上下文。
短短9分钟,累计处理约444万Token,其中约206万Token消耗在上下文压缩相关操作上。连续完成了6次压缩,第7次还在进行,最终模型也没给出回答,用户只能手动终止。
日志里还出现了一条警告:Unknown model gpt-6.2-sol is used,表明客户端当时没有正常识别新模型,而是使用了备用元数据。
这对付费用户尤其烦人。以前用AI写代码,主要担心模型能不能理解需求、生成的代码有没有问题。现在还得考虑客户端版本、工具权限、上下文管理,以及升级以后原来的配置还能不能正常使用。
原本希望AI能接手更多工作,结果自己还得操心一堆以前没有的事情。
模型越来越强,用户开始给AI重新分工
GPT-6.2也收获了不少好评。
有国内开发者让新版Astra审查一个6万多行代码的项目,发现了以前遗漏的问题。还有人使用新版Sol完成涉及101个文档的重构,约12分钟就处理完了。
Artificial Analysis的评测也能看出,这次模型升级并非没有进步。
Astra的综合智能指数达到62分,发布时排名全球第二。但在专门测试编程Agent的Coding Agent Index中,6.2 Astra和上一代成绩持平,新版Sol反而比6.1 Sol下降了3分。
综合能力和实际编程表现之间,确实存在差距。
现在已经有开发者开始重新安排不同模型的工作。
V2EX那篇退订帖里,有位用户分享了自己的工作流:让GPT负责测试和代码审查,Claude处理后端开发,Gemini承担部分UI设计,甚至允许Claude忽略GPT提出的不合理优化建议。
GPT的代码审查能力依然受到认可,但涉及实际开发和项目规划时,这位用户更愿意把工作交给Claude和Gemini。
以前大家都希望一个Agent能独立完成整个项目,现在有些开发者已经开始根据模型的特点重新分配任务,让几个AI互相检查、互相配合。
毕竟,谁也不想每次安排完工作,都得隔三差五回来看看AI有没有停工,更不想第二天打开项目,发现又多了一堆需要自己收拾的代码。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”