GPT-6徒手“修”好千问小模型,AI开始动别人的脑子了



摘要:
核心或在于,它触到了 AI 产业当前最大的两个命题:一是“模型优化是否还必须依赖大规模训练”,二是“谁有权定义和修改别人的模型”。
凤凰网科技 出品
作者|Dale
编辑 | 董雨晴
11 月 3 日,一张截图在中文互联网刷屏:MIT CSAIL 团队让 OpenAI 的 GPT-6 Astra 直接读取并修改阿里巴巴 Qwen3.5-0.8B 模型的权重,只改动了 131072 个参数,约占该模型 8 亿参数的 0.016%,就将其在 MATH-500 数学基准上的成绩从 7.9% 拉升至 48.1%,指令遵循能力(IFEval)提升约 3 倍。全程没有梯度下降,没有反向传播,没有传统意义上的“训练”。
团队给这套方法起了个新名字:权重空间编程(Weight-Space Programming,WSP)。
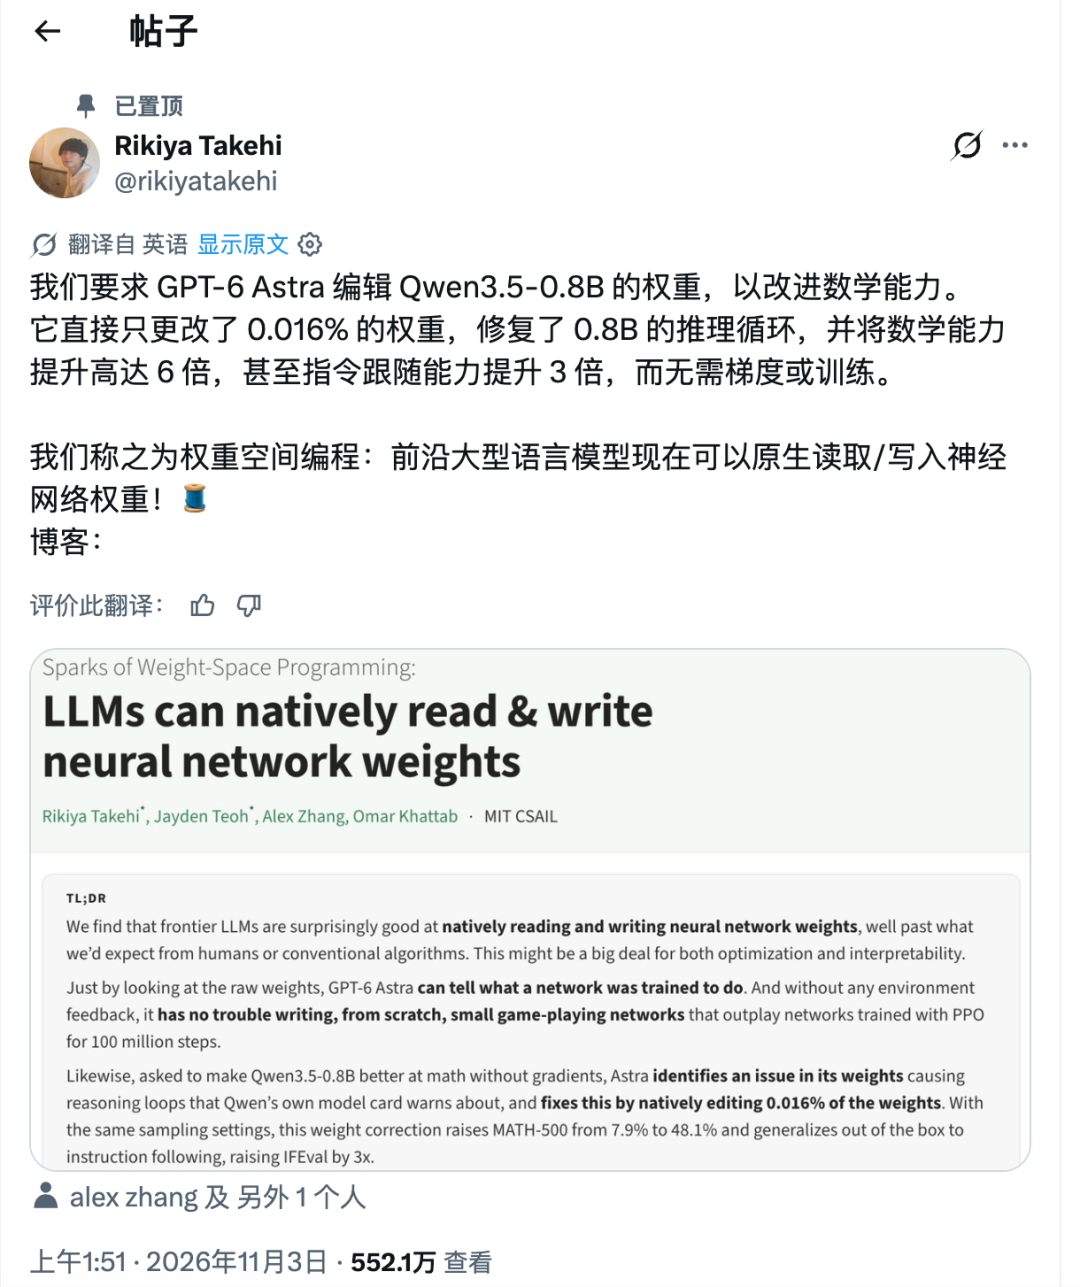
“我们发现早期迹象表明,前沿大型语言模型(LLMs)在原生地阅读、编写和推理神经网络权重方面出人意料地出色。模型可能将原始权重视为可读、可编辑的代码,而不是通过训练:直接诊断故障并修补它们”,MIT CSAIL 团队的相关研究人员表示。
需要注意的是,该实验还没有产出经过同行评审的论文,仅以博客形式发布。但消息一出,X 上原帖还是迅速积累大量曝光,过去14个小时,原贴浏览量超过了550万。
一条早期实验,为何能引发这个量级讨论?
核心或在于,它触到了 AI 产业当前最大的两个命题:一是“模型优化是否还必须依赖大规模训练”,二是“谁有权定义和修改别人的模型”。
优化模型,可以不靠训练了?
根据 MIT CSAIL 博客原文,研究者给 GPT-6 Astra 提供了一个可读写权重的 Python 沙箱环境,并允许其使用 GSM8K 和 MATH 训练集中的练习题进行有限次数的前向推理。Astra 首先要做的不是“随机改动参数碰运气”,而是先进行诊断:它发现 Qwen3.5-0.8B 在数学任务上反复生成相同内容,最初的 96 条测试回答中,有 85 条撞上了 32768 个 token 的输出上限,即典型的“推理循环”。Astra 随后将问题定位到第 15 层和第 19 层的多层感知机(MLP),削弱其中的重复信号,最终修改的权重只占模型总量的 0.016%。
更关键的是,研究者做了对照实验。在允许 50 轮前向推理的设定下,MATH-500 得分从 7.9% 升至 48.1%,GSM8K 从 13.8% 升至 67.1%;但当把目标换成原本很少陷入推理循环的 Gemma 3 270M 时,同样的方法最多只能把 MATH-500 从 6.8% 推到 7.7%。
这里面权重空间编程消除的是模型已有能力发挥过程中的障碍,而不是凭空创造模型原本不具备的能力。 换句话说,Astra 做的不是“给 0.8B 的小模型灌注新智能”,而是“解开捆住它的绳子”。
除了Qwen3.5-0.8B 案例,该团队还逐一向 Astra 提供来自 4 个游戏策略的原始权重。这四个策略共享完全相同的架构、输入和动作。在没有提供任何工具或选项的情况下,它正确地命名了所有四个:Breakout、Pong、Pac-Man、Freeway。接下来,修复权重:一个PPO汽车策略在坡道上反复卡住。给定权重、场景和1次失败的轨迹,Astra在一轮回复中无需使用工具就写出了一个补丁。通过仅编辑3.5%的权重,它实现了100%的成功率。
这恰恰是这个实验最让业界震动的地方:它将“模型优化”和“神经网络权重的更改”从一门依赖算力、数据和梯度的工程学,部分转化为了可以用自然语言描述目标、由模型自主完成的诊断任务。博客中展示的另外两组实验进一步放大了这种想象空间,Astra 仅凭原始权重就判断出小型网络是为哪款游戏训练的;在不允许训练数据、不允许梯度的条件下,从零写出的 MinAtar 游戏策略网络超过了 PPO 训练 1 亿步的基线。
需要强调的是,大量从业者最关心的是,这里面到底能有多少效率提升,计算量与模型训练相比有高效多少。
据表述,Astra 消耗了 Python 分析环境和最多 50 轮前向推理。省掉的是梯度训练,诊断与验证的成本依然存在。但对一个推理成本被持续压缩的行业而言,“修一个 0.8B 模型”从一次需要训练基础设施的工程,变成了一笔 API 调用,账是非常好算的。
短期是效率故事,长期是权力故事
从产业视角看,这件事的影响力要分三层看。
第一层:模型后市场的降本叙事。 目前行业对中小模型的优化,主要依赖蒸馏、微调、LoRA 等路径,背后仍是训练或类训练的算力投入。如果“前沿大模型直接读写小模型权重”被验证为可复制的通用方法,开源生态里大量“够用但不完美”的小模型,将第一次拥有一种绕过训练基础设施的修复通道。对算力受限的团队,这几乎包括中国绝大多数 AI 应用公司,这不是锦上添花,而是绕开算力封锁的一条小路。
第二层:模型资产的“可诊断化”。 这个实验本质上证明了前沿模型具备一种此前只在理论上讨论的能力:把另一个模型的权重当作可以阅读、理解的“文本”。所谓模型权重,简单的理解就是,神经网络里的一大堆数字,它决定了模型“看到什么、算出什么”,也相当于模型学到的所有经验,改这些数字就等于改模型的本事。
当模型行为可以被定位到“第 15 层和第 19 层的某个重复方向”,机制可解释性(mechanistic interpretability)就从论文走进了工程现场。谁掌握最强的“读模型”能力,谁就掌握模型审计、对齐验证的制高点,这在各国监管强化 AI 安全审查的当下,战略价值不亚于模型本身。
第三层:递归自我改进(RSI)的实证信号。 博客作者明确将这项工作指向 RSI:模型开始理解并修改神经网络本身,这是“AI 帮助人类训练模型”到“AI 参与优化模型”的一步跨越。这也是资本市场最敏感的神经,AI 迭代的瓶颈如果部分从“数据与算力”转向“模型自身的诊断能力”,scaling law 之外的第二条曲线就有了雏形。
当别人的模型成了被修改的对象
这个实验最有冲击力、也最容易被忽略的一个细节是:被修改的对象是阿里的 Qwen3.5-0.8B,一个在中文开发者生态中影响力不小的开源模型。修改它的,是 OpenAI 的闭源旗舰。
这构成了一幅需要认真对待的权力图景:最强的闭源模型,正在成为审视和改写开源模型的“标准答案”。 当 GPT-6 Astra 可以诊断 Qwen 的缺陷,它实质上获得了一种对该模型的“裁判权”,它说了算这个模型哪里有病、该怎么修。而对开源社区而言,自己的模型在被别人修好的同时,也把自己的“病理报告”暴露给了对方。
从商业竞争看,这种不对等是赤裸的:OpenAI 的旗舰模型可以随意读取、分析、修改竞争对手(哪怕是开源领域的标杆产品)的内部结构,而反向操作目前不存在,目前尚不存在任何开源模型具备对 GPT-6 Astra 做同样事情的能力与授权。一种事实上的“智能霸权”可能会形成:霸权不在于谁的模型分数高,而在于谁拥有定义“什么是正确的模型”的能力。
但也要把话说全。在现阶段,把 WSP 直接定性为霸权还太早。三点理由:其一,实验的对照结论已经表明,这套方法目前只能“除障”不能“造能”,它修得好推理循环,却给 Gemma 3 270M 变不出数学能力,距离通用的“模型改造武器”还很远;其二,被修改的是开源权重,开源本身就是以让渡部分控制权换取生态扩散的商业模式,“能被修复”也是开源模型的价值之一;其三,这项技术如果成立,其最大的受益者可能恰恰是开源生态——大量无法负担训练算力的小团队,第一次可以借助别人的前沿模型修复自己的模型。
真正需要警惕的是趋势而非现状。如果“读模型、修模型”的能力沿着当前轨迹持续扩大,全球 AI 能力图谱将分化出清晰的两个层级:掌握顶级闭源模型的少数公司位于上游,拥有“读改写”一切模型的特权;届时,竞争的胜负手将不再是模型本身,而是“谁有资格修改谁的模型”。
对监管者和产业界而言,这个实验留下的命题比它的成绩更有价值:当模型开始修改模型,模型安全的审查对象要从单个模型,扩展到“模型之间的关系”。这或许是一场热烈的讨论背后,真正值得严肃对待的信息。